
인텔 GPU D시리즈, 메모리 480GB로 엔비디아 B300 넘었지만 가격·출시는 미정
선호 출처로 추가
선호 출처로 추가하면 Google 주요 뉴스에 위키트리 기사가 더 자주 표시됩니다.
인텔 GPU D시리즈, 최대 480GB LPDDR5X·1.3PFLOPS·350W 공랭 AI 추론 가속기
카드 1장에 3000억 파라미터, 가격·출시일은 미공개
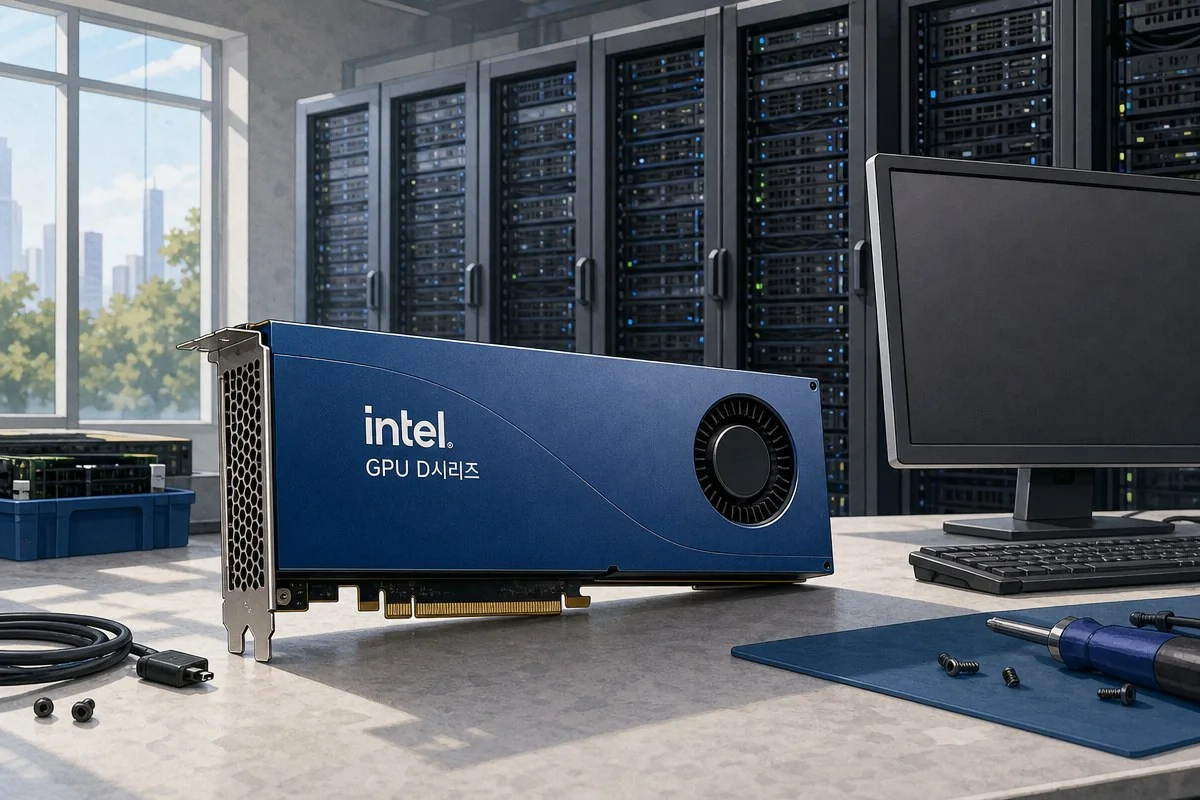
인텔이 최대 480GB 메모리를 얹은 AI 추론 전용 가속기 ‘인텔 GPU D시리즈(Intel GPU D-series)’를 공개했다. 코드명 ‘크레센트 아일랜드(Crescent Island)’로 알려졌던 제품이다. 최근 열린 오픈 컴퓨트 프로젝트(OCP) 글로벌 서밋에서 정식 이름과 핵심 사양이 처음 함께 나왔다.
테크레이더(TechRadar)에 따르면 이 제품은 엔비디아의 블랙웰 울트라 B300(288GB HBM3e)을 넘어 데이터센터 GPU 가운데 메모리 용량이 가장 큰 제품이 됐다. 다만 가격과 일반 출시 시점은 아직 공개되지 않았다.
게임용 GDDR7 대신 노트북용 LPDDR5X를 택했다
가장 눈에 띄는 대목은 메모리 종류다. 인텔은 최신 그래픽카드에 쓰이는 GDDR7 대신 LPDDR5X(노트북 등 전력 효율이 중요한 기기에 흔히 쓰는 저전력 D램)를 골랐다. 테크레이더는 이 구성이 전통적인 게이밍 그래픽카드가 아니라 AI 추론의 메모리 용량과 전력 효율을 우선한 설계라고 짚었다.
비교 대상도 보도에 나온다. 인텔의 이전 가속기 가우디 3(Gaudi 3)는 128GB 통합 HBM(고대역폭 메모리)을 탑재했다. 한 해외 매체는 HBM에서 LPDDR5X로 바뀐 만큼 단순 비교는 어렵다고 전제했다. LPDDR5X는 HBM보다 느리지만 효율이 높은 메모리라는 설명이다.
인텔은 이 용량을 앞세워 카드 한 장으로 최대 3000억 개 파라미터(AI 모델의 규모를 가늠하는 매개변수)를 가진 대규모 언어모델을 돌릴 수 있다고 밝혔다. 8개 GPU를 묶은 시스템에서는 1조 개를 넘는 파라미터의 모델까지 수용할 수 있다는 설명이다. 긴 프롬프트와 동시 추론 요청, 기업용 AI 서비스, 즉각적인 반응이 필요한 로보틱스 같은 용도가 겨냥 대상이다.
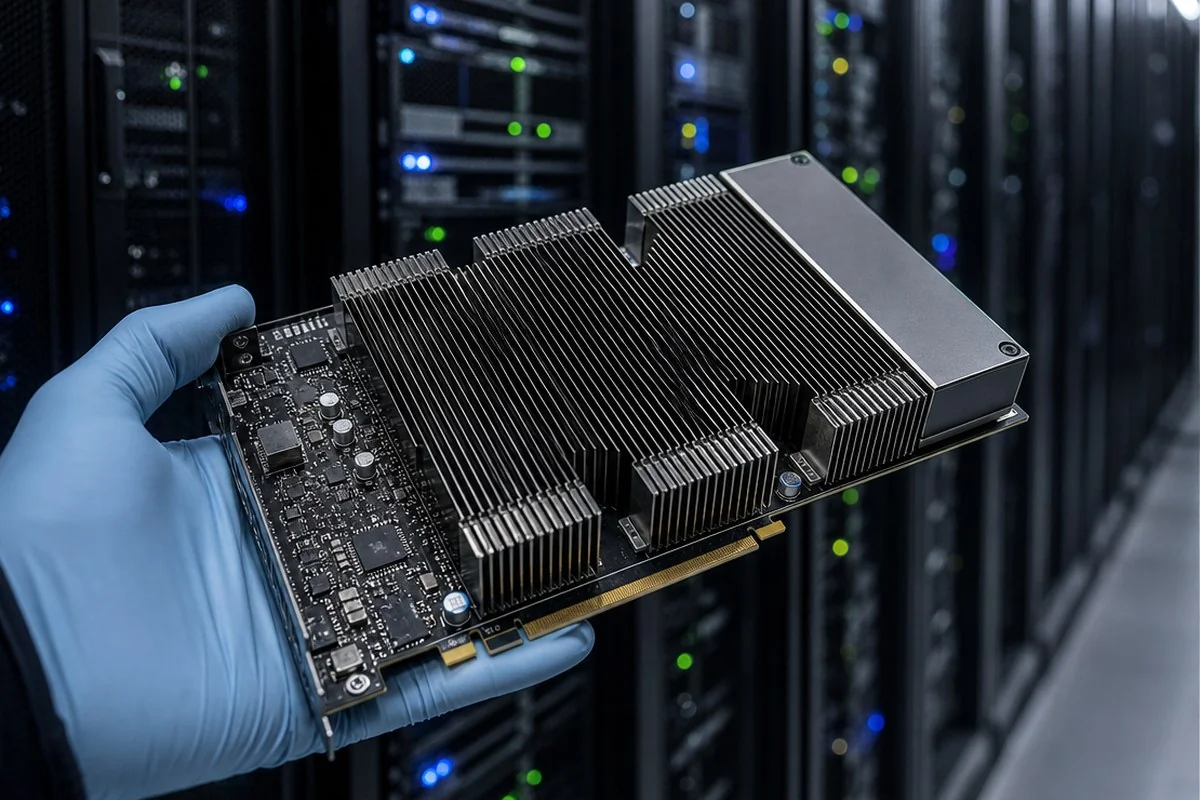
1.3PFLOPS·1.5TB/s·350W, 공개된 사양
이번에 인텔은 처음으로 이론상 최고 성능 목표를 내놨다. FP8(8비트 부동소수점, 고정밀 형식보다 메모리 부담을 줄이면서 AI 연산을 가속하는 방식) 기준 1.3페타플롭스다. 메모리 대역폭은 초당 1.5테라바이트로 확정됐다. 소비전력 범위(전력 엔벨로프)는 350W다.
인텔은 공식 설명에서 최신 Xe3P 아키텍처 기반이라고 밝혔다. 메모리 용량과 연산 성능, 전력 효율의 균형이 실제 추론 워크로드에 맞춘 접근이라는 주장이다. 한 해외 매체는 크레센트 아일랜드가 Xe3P 아키텍처로 만든 첫 칩이라고 전했다. 그래픽 전용 기능 유닛이 대부분 없어 엄밀히는 GPU보다 대규모 병렬 컴퓨팅 아키텍처에 가깝다는 분석도 덧붙였다.
테크레이더는 메모리 용량이 곧 응답 속도를 뜻하지 않는다고 지적했다. 480GB는 추론 중 방대한 모델 가중치와 관련 데이터를 곁에 두는 데 유리하다. 하지만 실제 처리 속도는 대역폭과 연산 자원, 소프트웨어, 워크로드 특성에 따라 달라진다는 것이다.
공랭 PCIe 카드로 기존 서버에 꽂는다
D시리즈의 또 다른 특징은 설치 환경이다. 인텔은 표준 PCIe 폼팩터에 공랭 방식을 택했다. 인텔 GPU 플랫폼 전반에서 애플리케이션을 옮겨 쓸 수 있는 호환성도 내세웠다. 특별한 냉각 설비나 완전히 새로운 랙 인프라 없이 기존 데이터센터에 넣기 쉽게 하려는 설계다.
한 해외 매체는 이 점을 엔비디아의 베라 루빈 NVL72와 견줬다. 이 랙 규모 시스템에 들어가는 루빈 GPU 72개는 각각 FP8 기준 이론상 17.5PFLOPS를 낸다. 대신 액체 냉각이 필요하다. 반면 D시리즈는 엔비디아 HGX 시스템처럼 최대 8개 GPU까지 확장하는 전통적인 공랭 랙 서버에 들어간다. 두 제품이 겨냥하는 성능 범위와 인프라 요건이 전혀 다르다는 평가다.
인텔은 이 가속기를 제온 프로세서와 짝지을 계획도 밝혔다. CPU가 작업을 조율하고 데이터 이동을 관리하며 GPU 가속이 필요 없는 일을 맡는 구조다. 검색, 추론, 오케스트레이션(작업 조율), 외부 도구, 실행 같은 여러 단계로 이뤄지는 최근 AI 시스템을 염두에 둔 접근이다.
가우디의 부진 뒤 다시 꺼낸 추론 카드
인텔은 이번에도 소프트웨어 생태계를 강조했다. 이미 AI용으로 구축한 ‘공통 Xe 소프트웨어 기반’을 내장 GPU와 개별 GPU 제품 전반에서 활용한다는 계획이다. OEM, ODM, 네오클라우드, 독립 소프트웨어 업체, 어플라이언스 업체, AI 네이티브 기업 등 폭넓은 생태계와 협력 중이다. 고객 샘플링은 이미 진행 중이지만 본격적인 출시 계획은 구체적으로 제시하지 않았다.
한 해외 매체는 인텔의 과거 행보를 짚었다. 가우디는 엔비디아와 의미 있게 경쟁하지 못했고 후속작 ‘팰컨 쇼어스’ GPU는 취소됐다. 또 다른 매체는 데이터센터 GPU 맥스 계열의 실패와 일관된 AI 전략으로 이어지지 못한 인수들을 언급하며, D시리즈가 인텔에 AI 가속기 시장의 발판이 될지는 지켜봐야 한다고 평가했다. 이번에는 학습이 아닌 추론에 초점을 맞춘 점이 달라졌다.
인텔 데이터센터 그룹의 아닐 난두리 AI 제품·GTM 담당 부사장은 “추론이 AI의 결정적 워크로드가 되고 있으며 기업에는 적절한 비용으로 적절한 성능을 내는 인프라가 필요하다”고 말했다. 이어 고용량 추론을 실제로 배포하기 쉽고 확장 비용도 경제적으로 만드는 데 집중하겠다고 밝혔다.
데이터센터 시스템·솔루션 그룹의 니콜라 뒤베(Nicolas Dubé) 기업 부사장은 오픈 모델이 기업의 AI 도입 선택지를 넓히고 있다고 말했다. 그는 워크로드별로 알맞은 지능과 연산 자원, 경제성을 맞춰줄 인프라가 필요하다며 인텔이 말하는 ‘put every prompt in its place’(모든 프롬프트에 알맞은 자리를)의 뜻이 그것이라고 설명했다.
한편 한 해외 매체 칼럼은 메모리 공급이 빠듯한 상황에서 이런 대용량 AI 제품이 소비자용 메모리 생산 여력을 더 잠식할 수 있다는 우려를 제기했다. 이는 필자의 의견이다. 인텔은 이 부분에 대해 따로 입장을 밝히지 않았다.